
本日はUnslothを用いたVLMのファインチューニング方法について紹介します。
はじめに
ここ数年gpt-ossやQwen3.6などOSSのLLMやVLMが公開されていますが、汎用性がある一方で業務に特化したタスクをこなすにはハードルが高いのが現状です。 これを解決する方法の一つに「ファインチューニング」があります。 今回はUnslothという、LLM のファインチューニング(LoRA/QLoRA)を劇的に高速化しメモリ効率を最適化するために開発されたオープンソースライブラリを用いたファインチューニング方法を紹介します。
ファインチューニングとは
事前学習済みモデルの一部もしくはすべてのパラメータに対して学習を行い、パラメータの微調整をすることです。
事前学習とは別の新しいデータを用意し学習することで、専門的なタスクへの対応が可能です。
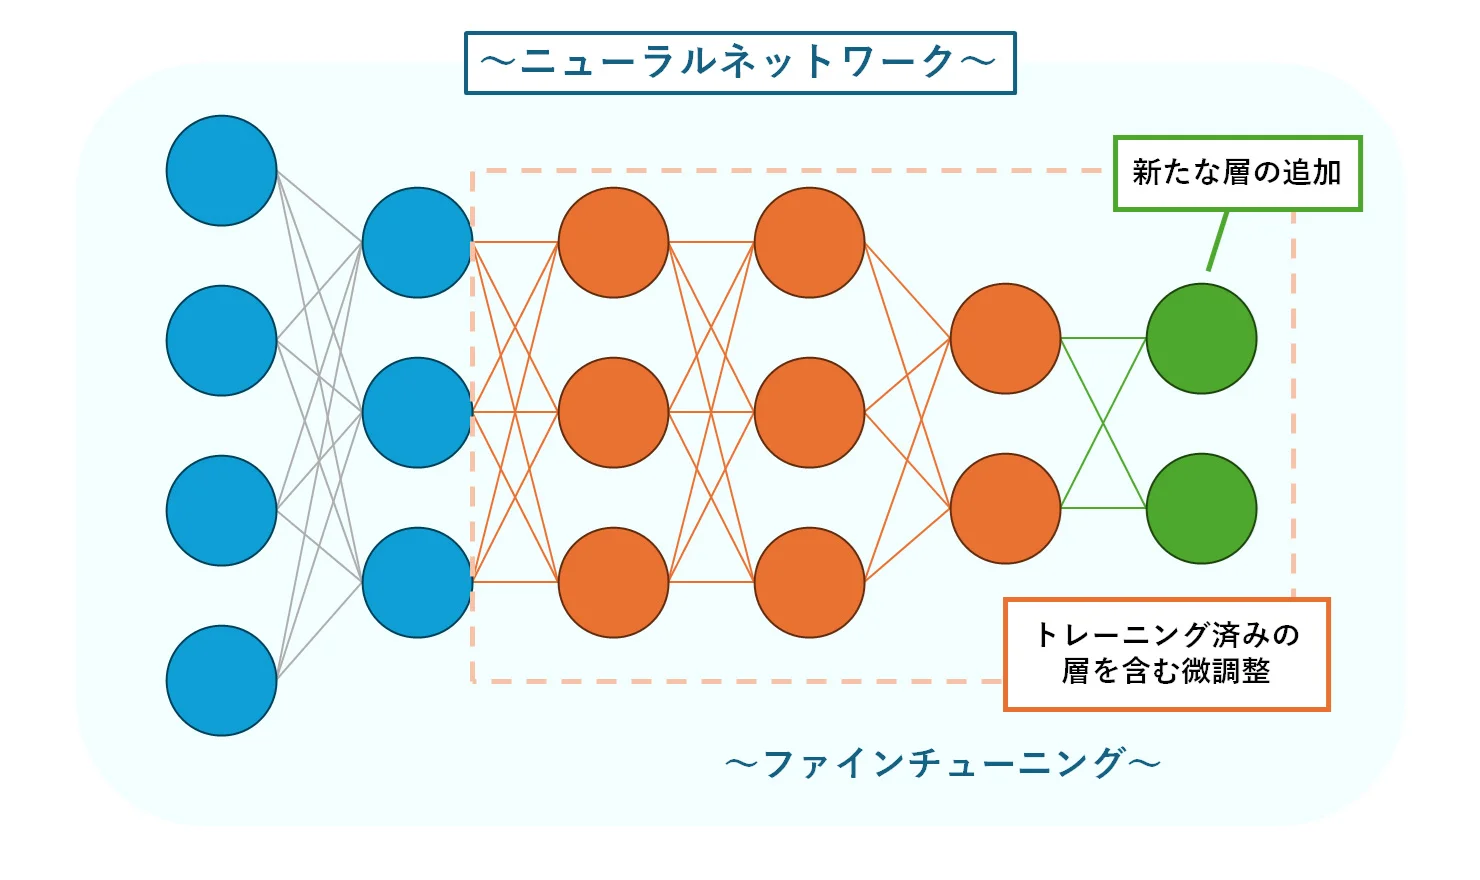 (出典:
ファインチューニングの実施手順
フランスの「Mistral AI」が作成した「Ministral 3 3B Instruct 2512」をベースに、LoRA学習でのファインチューニングの手順を紹介します。
Unslothのドキュメント、Google Colabのチュートリアルのコードがあるので、それをベースに作成すれば簡単にファインチューニングが可能です。
今回は、「手書きの数式画像」を読み込ませたら「正しいLaTeXコード」を出力するというOCRに特化したAIを作ります。
ステップ1:データセットの選定と準備(Data Prep)
ファインチューニングを行うには、まず実現したい目的に合わせてデータセットを選定・収集する必要があります。
今回はチュートリアルで使われている既存の公開データセットを用いてファインチューニングを行います。
データセット:unsloth/LaTeX_OCR · Datasets at Hugging Face
使用するデータセットの中身とプロンプトは以下の通りです。
例)
■画像
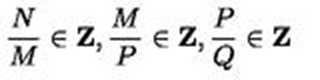 (出典:
■GT
{ \frac { N } { M } } \in { \bf Z } , { \frac { M } { P } } \in { \bf Z } , { \frac { P } { Q } } \in { \bf Z }
■プロンプト
Write the LaTeX representation for this image.
ステップ2:モデルの学習と保存(Train)
今回は、モデル全体の膨大なパラメータを書き換えるのではなく、新たに少数のパラメータを追加してその差分のパラメータを調整することで省メモリかつ高速に特訓を行う手法であるLoRA(Low-Rank Adaptation)を用いて学習を実施します。
モデルの学習は、大きく分けて「2-1:データの用意」「2-2:モデルとLoRAの設定」「2-3:学習の実行と保存」の順番で行います。
2-1:データの用意
LLMやVLMを学習させるためには、AIが理解しやすい「対話(チャット)形式」の学習データを作る必要があります。
まずは実際にデータセットをロードし、学習データを作成、すなわちモデルが学習できる形式に変換する前処理を行います。
from unsloth.trainer import UnslothVisionDataCollator
from trl import SFTTrainer, SFTConfig
from unsloth import is_bf16_supported, FastVisionModel
import torch
from datasets import load_dataset

from data_prep import convert_to_conversation

# --- データセットのロードと整形 ---
dataset = load_dataset("unsloth/LaTeX_OCR", split = "train")
converted_dataset = [convert_to_conversation(sample) for sample in dataset]
データセットのロードと整形で使用されている関数の中身は以下の通りです。
この関数を用いて学習用のフォーマットに整形しています。
instruction = "Write the LaTeX representation for this image."

# ---データセットの「画像」と「正解テキスト」を、対話形式のリストに変換する ---
def convert_to_conversation(sample):
    conversation = [
        { "role": "user",
          "content" : [
            {"type" : "text",  "text"  : instruction},
            {"type" : "image", "image" : sample["image"]} ]
        },
        { "role" : "assistant",
          "content" : [
            {"type" : "text",  "text"  : sample["text"]} ]
        },
    ]
    return { "messages" : conversation }
※今回は学習スクリプトの中でデータを整形していますが、実務で大規模な学習を行う場合は学習時間を短縮するためにステップ1の作業として事前に前処理を済ませたデータセット(JSONファイル等)を用意しておくアプローチも一般的です。
2-2:モデルとLoRAの設定
学習データを準備できたら、次にどのAIモデルを使うのかを定義します。
ベースとなるモデルを読み込んだ後、基底モデルに「LoRAアダプター」の設定を実施します。
ここで、画像認識(vision)や言語生成(language)のどのレイヤーを学習対象にするかなどを指定します。
# 2-1の続き
# --- モデルとトークナイザーのロード ---
model, tokenizer = FastVisionModel.from_pretrained(
    "unsloth/Ministral-3-3B-Instruct-2512",
    load_in_4bit = False, # Use 4bit to reduce memory use. False for 16bit LoRA.
    use_gradient_checkpointing = "unsloth", # True or "unsloth" for long context
)

# --- LoRAアダプターの設定 ---
model = FastVisionModel.get_peft_model(
    model,
    finetune_vision_layers     = True, # False if not finetuning vision layers
    finetune_language_layers   = True, # False if not finetuning language layers
    finetune_attention_modules = True, # False if not finetuning attention layers
    finetune_mlp_modules       = True, # False if not finetuning MLP layers

    r = 32,           # The larger, the higher the accuracy, but might overfit
    lora_alpha = 32,  # Recommended alpha == r at least
    lora_dropout = 0,
    bias = "none",
    random_state = 3407,
    use_rslora = False,  # We support rank stabilized LoRA
    loftq_config = None, # And LoftQ
    # target_modules = "all-linear", # Optional now! Can specify a list if needed
)
2-3:学習の実行と保存
いよいよ準備が完了したため、学習を開始します。
バッチサイズや学習ステップ数などの細かな設定は SFTTrainer というクラスが管理してくれるため、実際に学習をスタートさせるソースコードは trainer.train() の1行だけです。
学習が終わったら、モデルを保存して完了です。
# 2-2の続き
# ---トレーナーの設定---
trainer = SFTTrainer(
    model = model,
    tokenizer = tokenizer,
    data_collator = UnslothVisionDataCollator(model, tokenizer), # Must use!
    train_dataset = converted_dataset,
    args = SFTConfig(
        per_device_train_batch_size = 4,
        gradient_accumulation_steps = 2,
        warmup_steps = 5,
        max_steps = 30,
        # num_train_epochs = 1, # Set this instead of max_steps for full training runs
        learning_rate = 2e-4,
        logging_steps = 1,
        optim = "adamw_8bit",
        fp16 = not is_bf16_supported(), # Use fp16 if bf16 is not supported
        bf16 = is_bf16_supported(), # Use bf16 if supported
        weight_decay = 0.001,
        lr_scheduler_type = "linear",
        seed = 3407,
        output_dir = "outputs",
        report_to = "tensorboard",     # For Weights and Biases

        # You MUST put the below items for vision finetuning:
        remove_unused_columns = False,
        dataset_text_field = "",
        dataset_kwargs = {"skip_prepare_dataset": True},
        max_length = 2048,
    ),
)

# --- 特訓の実行 ---
trainer_stats = trainer.train()

# --- 学習成果の保存(ローカルに保存) ---
model.save_pretrained("ministral_lora")  # Local saving
tokenizer.save_pretrained("ministral_lora")
ステップ3:推論と結果の確認(Inference)
学習が完了したら、実際に数式を正確に読めるようになったか推論を実行してテストします。
今回はテスト用データセットの冒頭の結果を確認してみます。
Unslothには disable_adapter_layers() という非常に便利な機能があり、これを使うと学習した知識(LoRA)を一時的にオフにして、ファインチューニングを行う前の「元モデル」の実力を確認することができます。
from unsloth import FastVisionModel
from IPython.display import display, HTML
import html
import re

indices_to_test = [0]
results_compare = []
FastVisionModel.for_inference(model)

# --- テスト用データセットをロード ---
test_dataset = load_dataset("unsloth/LaTeX_OCR", split="test")

# ---【特訓前】元モデルでの推論 ---
print("元モデル(LoRAオフ)で推論中...")
model.disable_adapter_layers() # LoRAアダプターを一時的にオフにして使用しないように設定

for i in indices_to_test:
    image = test_dataset [i]["image"]
    instruction = "Write the LaTeX representation for this image."

    # 推論時にも学習時と同じシステムプロンプトを与える
    messages = [
        {"role": "user", "content": [{"type": "image"}, {"type": "text", "text": instruction}]}
    ]
    input_text = tokenizer.apply_chat_template(messages, add_generation_prompt=True)
    inputs = tokenizer(image, input_text, add_special_tokens=False, return_tensors="pt").to("cuda")

    outputs = model.generate(**inputs, max_new_tokens=256, use_cache=True, temperature=1.5, min_p=0.1)
    results_compare.append({
        "index": i, "true_latex": test_dataset [i]["text"],
        "before_raw": tokenizer.decode(outputs[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True)
    })
元モデルの推論が終わったら、次は enable_adapter_layers() を使って特訓した知識をオンに戻し、学習後モデルとして推論を行います。
推論時のサンプリングパラメータについては、チュートリアルと同様の設定値(temperature=1.5, min_p=0.1)にしています。
# 元モデルでの推論の続き
# ---【特訓後】学習後モデルでの推論 ---
print("学習後モデル(LoRAオン)で推論中...")
model.enable_adapter_layers() # LoRAアダプターをオンにする

for i, res in enumerate(results_compare):
    idx = res["index"]
    image = test_dataset [idx]["image"]
    instruction = "Write the LaTeX representation for this image."

    messages = [
        {"role": "user", "content": [{"type": "image"}, {"type": "text", "text": instruction}]}
    ]
    input_text = tokenizer.apply_chat_template(messages, add_generation_prompt=True)
    inputs = tokenizer(image, input_text, add_special_tokens=False, return_tensors="pt").to("cuda")

    outputs = model.generate(**inputs, max_new_tokens=128, use_cache=True, temperature=1.5, min_p=0.1)
    results_compare[i]["after_raw"] = tokenizer.decode(outputs[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True)
このままでは推論結果が分かりにくいので、特訓前と特訓後の実力を簡単に比較できるように表にしてみました。
LaTeXコードの列に実際の推論結果、レンダリング結果の列に推論結果で出力されたLaTeXコードのレンダリング結果を表示しています。
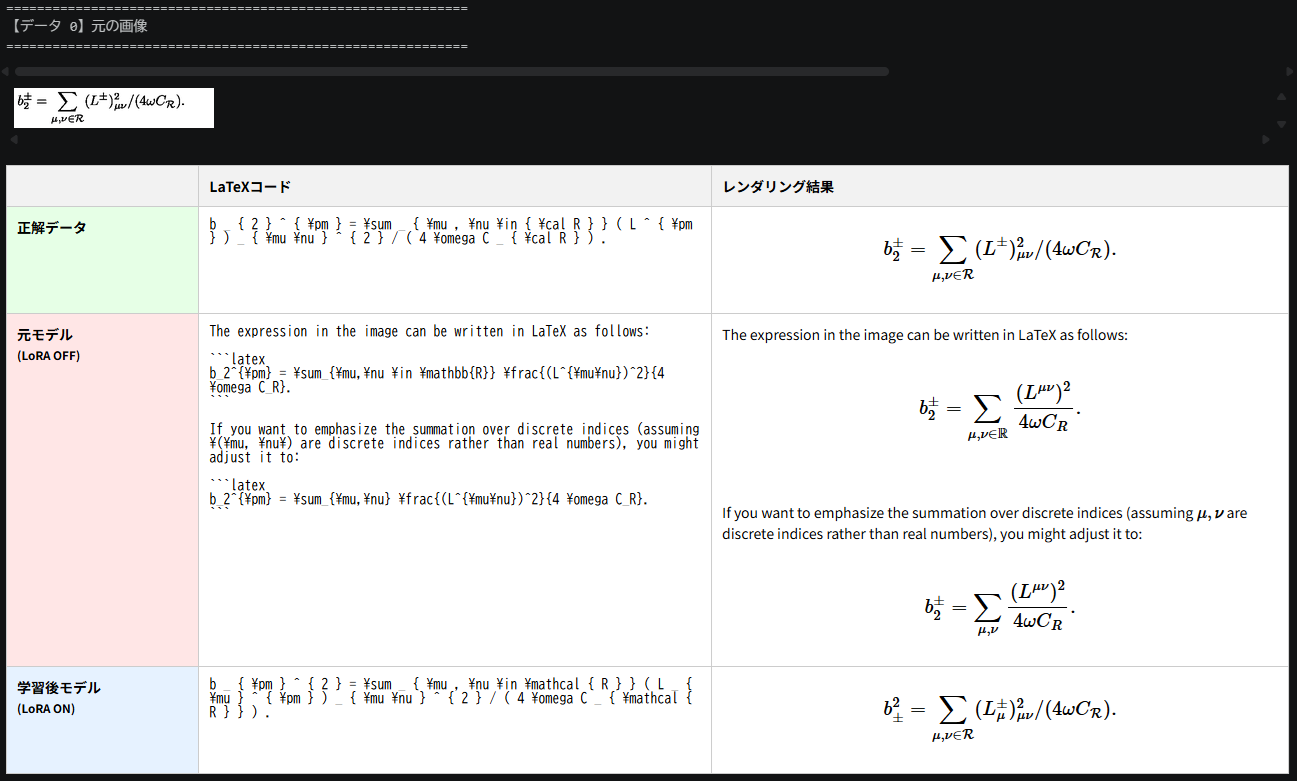
元モデルでの推論結果は正解データとは出力形式も数式も大きく異なっていますが、学習後モデルでの推論結果は正解データに極めて近い出力になっています。
ファインチューニングによって「数式をLaTeXで記述する」というタスクを正しく理解し、精度を向上させることができました。
学習後モデルでも一部正解データと異なる点がありますが、学習データを増やしたりステップ数を100~300程度まで伸ばしたりすることで100%に近い精度へと近づけることが可能です。
このように実際の業務でも一度の学習で終わるのではなく、学習時に「データセット」の質を高めたり「ハイパーパラメータ」を微調整したりして、モデルをより良い状態へと近づけていきます。
さらに、ファインチューニング後のモデルから最適な答えを引き出すために、推論時の「サンプリングパラメータ」を調整することでより高い精度を達成する可能性もあります。
学習(モデルの構築)と推論(モデルの活用)の両面から改善を繰り返すことが大切です。
まとめ
- Data Prep:目的に合わせたデータセットを用意する。
- Train:LoRA学習を実行する。
- データの用意:データのロードと学習形式への前処理(加工)
- モデルとLoRAの設定:ベースモデルの定義と学習パラメータの設定
- 学習の実行と保存:実際の計算処理と学習済みモデルの書き出し
- Inference:学習済みモデルを使って推論を実行し、結果を確かめる。
これがファインチューニングの一連の王道フローです。
最後に
Tech Blogを最後までお読みいただき、ありがとうございました。
最近では、受託開発プロジェクトにおいて、LLMやVLM を活用したソリューションの開発ニーズが高まっております。
我々のチームは、AI技術を駆使してお客様のニーズに応えるため、常に新しい挑戦を続けます。